生成AIに個人情報を入力してよいのか?結論と本記事の範囲
生成AIへの個人情報の入力は、条件を満たせば可能です。個人情報を含むかどうか、学習や閲覧があるか、契約と利用目的の組み合わせで決まり、全面禁止にする必要はありません。
この記事は、社内で生成AIを使い始めた、または使わせたい中小企業の経営者・管理部門・情シス担当の方に向けて書いています。全面禁止か全面許可かの二択ではなく、判断の基準をそろえることが目的です。AI導入全体の進め方は、詳しくはAI導入の全体像と進め方をご覧ください。
注意喚起とは:個人情報保護委員会が求めたこと
個人情報保護委員会は2023年6月に、生成AIサービスの利用に関する注意喚起を出しました。事業者には、利用目的の達成に必要な範囲内で個人情報を入力すること、応答以外の目的で学習に使われないかを確認することを求めています。個人向けには、個人情報を不用意に入力しないことと、利用規約を確認することを促しています。
言い換えると、入力そのものを禁じてはいません。どの情報を、どんな条件のサービスに、何の目的で入れるかを確認せよ、という整理です。
判断基準とは:入力可否は4つで決まる
判断に使う要素を絞ると、個人情報の有無、学習の有無、保存先と契約、利用目的の4つです。この4つがそろえば、業務ごとに入力してよいかを決められます。
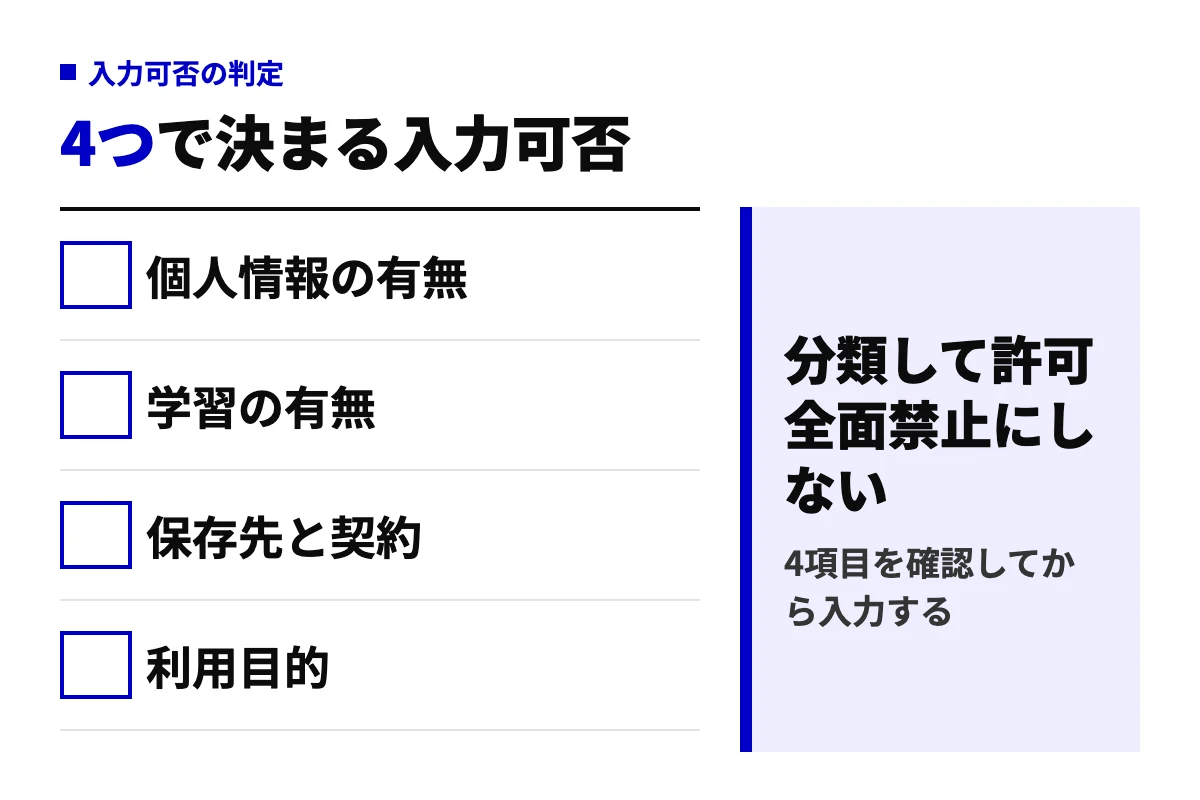
- 個人情報の有無:氏名や連絡先など、個人を特定できる情報が含まれているか。含まなければ以降の確認は軽くなります
- 学習の有無:入力した内容が、サービスのモデル改善(学習)に使われる設定か
- 保存先と契約:入力データがどの事業者の環境に保存され、契約上どう扱われるか
- 利用目的:本人に示した利用目的の範囲内での処理か
以降は、法律の整理、情報の流れ、漏洩の原因、判定表、ルールの作り方、プランの選び方の順に説明します。
個人情報保護法から見た生成AIへの「入力」と「第三者提供」の違い
学習に使われる設定への個人情報の入力は、第三者提供に当たり得ます。一方で、学習も閲覧もしない契約のもとでの入力は、提供に当たらないと整理されるのが一般的です(2026年9月時点)。個別の契約内容で結論が変わるため、最終判断は専門家への確認が前提です。
個人情報保護法で問題になるのは、「第三者提供」「委託」「クラウド例外」の3つの区分のどれに当たるかです。同じ生成AIでも、契約と設定によって区分が変わります。本人同意、事業者の利用、生成AIの例、必要な確認の観点で、第三者提供、委託、クラウド例外を並べると次の図になります。
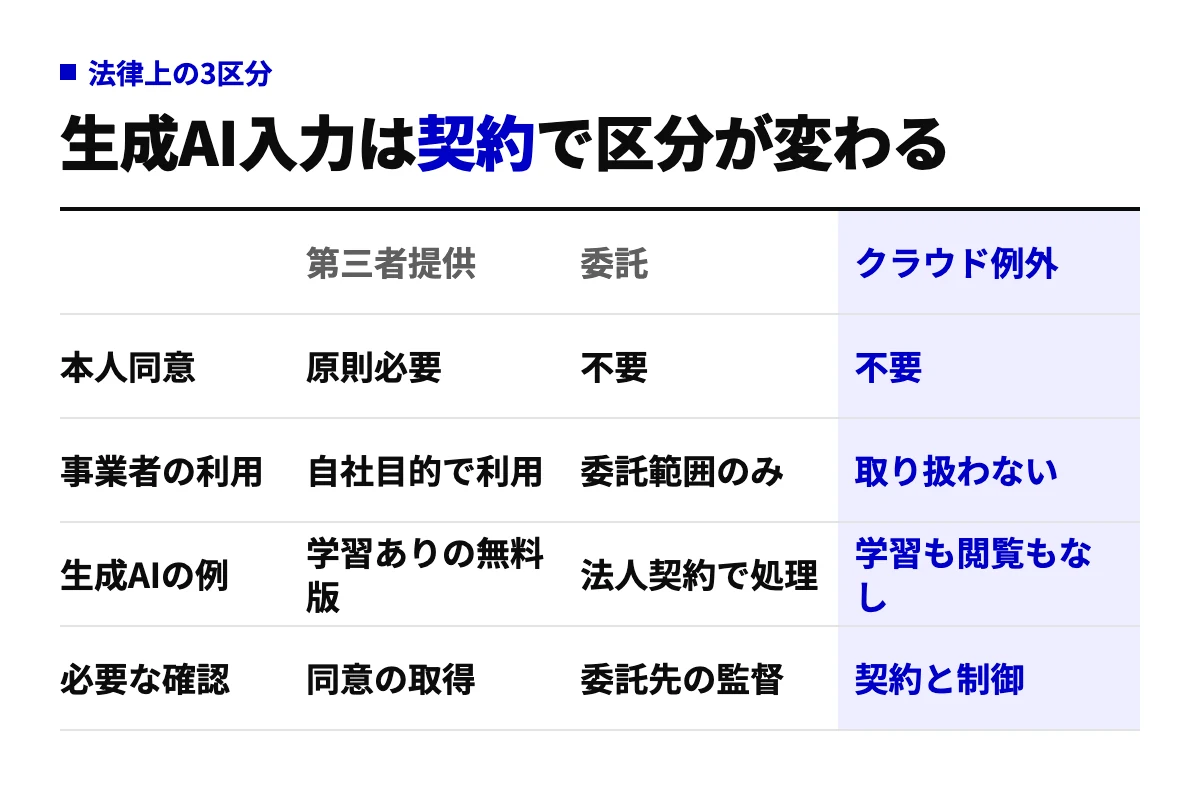
- 本人同意:第三者提供なら原則必要、委託とクラウド例外なら不要です
- 事業者の利用:第三者提供では自社目的で利用、委託では委託範囲のみ、クラウド例外では取り扱わない扱いです
- 生成AIの例:第三者提供は学習ありの無料版、委託は法人契約で処理、クラウド例外は学習も閲覧もなしの契約が典型です
- 必要な確認:第三者提供は同意の取得、委託は委託先の監督、クラウド例外は契約と制御の確認です
第三者提供とは:事業者が自社目的で使う区分
第三者提供とは、取得した個人データを本人以外の第三者に渡すことです。生成AIの事業者が入力内容を自社のモデル改善に使う設定なら、事業者側に自社の利用目的が生まれます。この場合は提供に当たり得るため、原則として本人の同意が必要になります。
個人向けの無料サービスは、既定で学習に使う設定になっているものが多いです(2026年9月時点)。学習ありの状態で顧客の氏名や住所を入力する行為は、この区分に入る可能性があります。
委託との違い:目的の範囲内で処理させる区分
委託とは、自社の利用目的の範囲内で、処理を外部に任せることです。法人契約で、入力内容を学習に使わず、契約で定めた処理だけを行う場合は、委託に整理されることがあります。委託であれば本人同意は不要ですが、委託先の監督義務が生じます。
監督とは、契約で取り扱いの範囲を定め、実際にその通り運用されているかを確認することです。契約書の確認と、設定の定期的な点検が実務上の中身になります。
クラウド例外の基準:学習も閲覧もしない契約
クラウド例外とは、事業者が個人データを取り扱わないことになっている場合は、提供にも委託にも当たらないとする整理です。契約で学習にも閲覧にも使わないことが定められ、アクセス制御が適切なら、この区分に入ると整理されます(2026年9月時点)。この場合も、契約と制御が実際に効いているかの確認は必要です。
どの区分でも、入力が本人に示した利用目的の範囲内かは別途確認が必要です。区分の整理は同意の要否を決めるものであって、目的外利用を許すものではありません。
個人情報保護委員会は、事業者向けの注意喚起で、利用目的の範囲内での入力と、学習利用の有無の確認を求めています(個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」)。
生成AIサービスの中で入力した情報はどう流れるか
入力した情報は事業者の環境へ送られ、履歴として保存され、設定次第で学習に使われます。クラウド型の生成AIでは、画面に打ち込んだ内容も、連携ツール経由で渡した内容も、いったん事業者のサーバーに送られます。
流れを工程で分けると、入力、送信、保存、学習、出力の5つです。どの工程で何が起きるかを知っておくと、確認する項目がはっきりします。
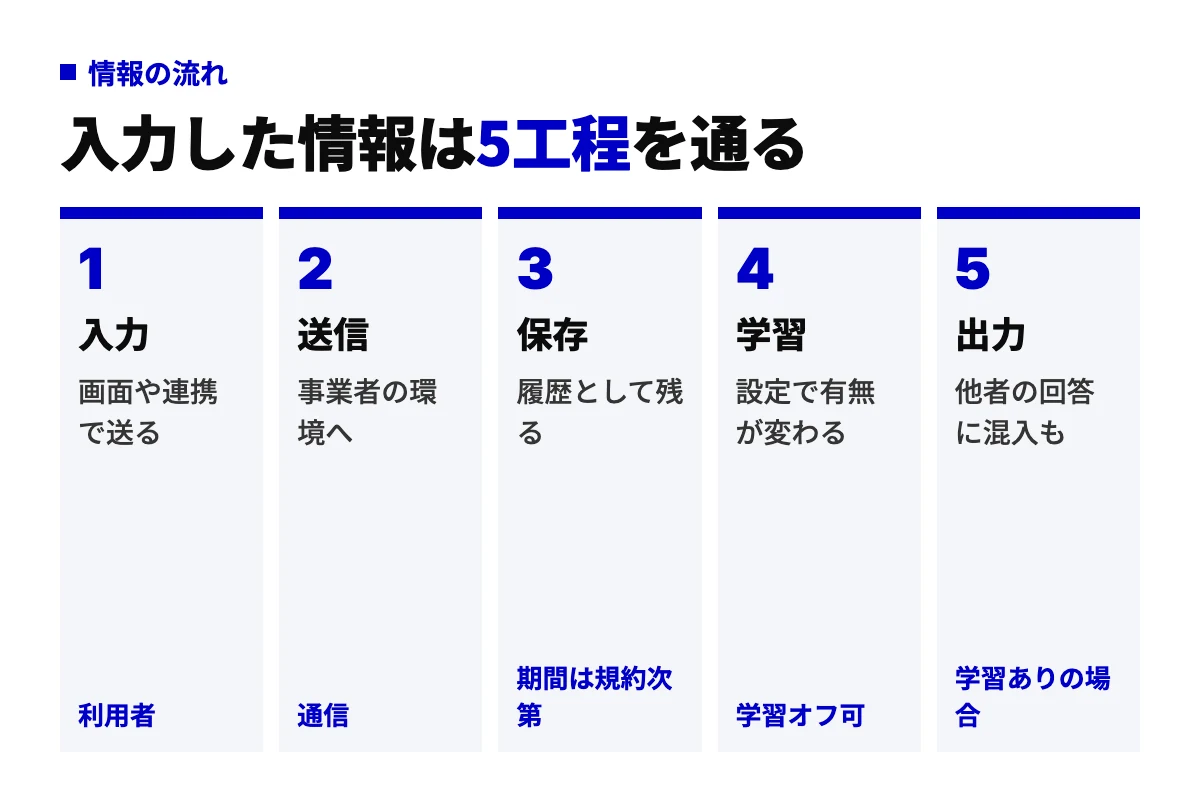
- 入力:画面や連携で送る。チャット画面だけでなく、メールや文書ツールとの連携も入口です
- 送信:事業者の環境へ。手元の端末を離れ、事業者が管理するサーバーへ渡ります
- 保存:履歴として残る。学習に使われなくても、一定期間は履歴やログとして保存されます
- 学習:設定で有無が変わる。モデル改善に使うかは、プランと設定で決まります
- 出力:他者の回答に混入も。学習に使われた情報は、他の利用者への回答に断片が現れる可能性があります
「学習されない」と「保存されない」の違い
学習オフの設定にしても、入力内容が保存されなくなるわけではありません。多くのサービスでは、不正利用の監視や障害対応のために、一定期間は履歴やログが残ります(2026年9月時点)。保存期間と閲覧の条件は、各社の規約と法人契約で異なります。
したがって、確認する項目は「学習に使われるか」と「どこに何日残り、誰が見られるか」の2つです。前者は設定画面で、後者は規約と契約で確認します。
外部連携と拡張機能の注意点
ブラウザ拡張や他ツールとの連携は、本体の設定とは別の経路になります。本体で学習オフにしていても、連携先のサービスが別の規約で動いている場合があります。連携を許可する前に、そのサービス単体の規約を確認する手順が必要です。
自社サーバーや端末内で動かすローカル運用なら、外部への送信は避けられます。ただし、端末の紛失や持ち出し、アクセス権の管理といった問題は残ります。送信先が変わるだけで、管理の仕事がなくなるわけではありません。サービスごとの違いは、詳しくは主要な生成AIサービスの比較と選び方にまとめています。
生成AIで個人情報が漏洩する原因とよく見るパターン
漏洩の多くは、入力の入口で起きます。生成AIそのものが破られるより、人が個人情報をそのまま入れる、学習に回る設定で使う、連携先に流れる、という入口の問題が大半です。
公開されている事例(各社の発表や報道)は、認証情報、ソースコード、アカウント情報、プロンプト、個人情報の流出といった種類に分かれます。どれも、サービスの中枢が破られたというより、端末や入力の側に原因があるものが目立ちます。
原因を分けると、そのまま入力、学習利用、外部連携、不正アクセス、共有ミスの5つです。
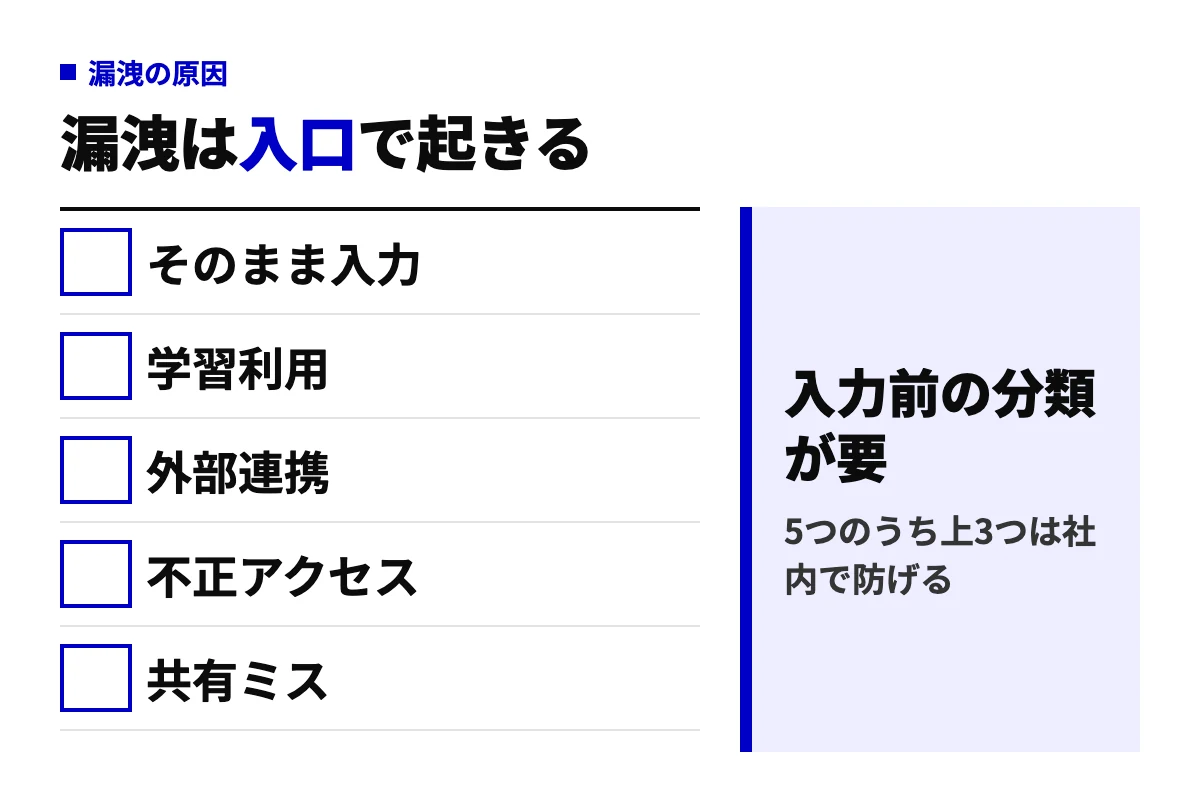
- そのまま入力:顧客情報や個人名を伏せずに入力する。最も多い入口です
- 学習利用:学習に使う設定のまま業務データを入れ、他者への出力に混入する経路です
- 外部連携:本体の設定とは別の規約で動く拡張機能や連携先へ流れる経路です
- 不正アクセス:端末のマルウェア感染や認証情報の流出で、履歴ごと盗まれる経路です
- 共有ミス:会話の共有リンクや出力結果を、誤って外部に公開する経路です
上の3つは社内ルールと設定で防げます。下の2つは端末管理とアクセス権の問題で、生成AIに限らない情報セキュリティの範囲です。
よく見るパターン:顧客対応文の下書きにメール本文をそのまま貼る
私たち株式会社くるみは、支援先の運用を見る中で、問い合わせメールを返信の下書きのためにそのまま貼るパターンを繰り返し見てきました。メール本文には、差出人の氏名、メールアドレス、署名の電話番号、案件の経緯が含まれています。個人向けの学習ありの設定で行われると、第三者提供の懸念と学習利用の懸念が同時に発生します。
これは、担当者の意識の問題ではなく、貼る前の手順が決まっていないことが原因です。氏名を記号に置き換えてから貼る、という一手順を決めるだけで大半は防げます。
よく見るパターン:議事録要約に社名と個人名入りの録音を渡す
もう一つ多いのは、会議の録音や文字起こしを、要約のためにそのまま渡すパターンです。録音には、参加者の氏名、取引先の社名、進行中の案件の詳細が含まれます。文字起こしツールと要約ツールが別のサービスだと、経路が2つに分かれ、確認漏れが起きやすくなります。
ここで挙げたパターンは、匿名の自社支援記録で第三者未検証です。複数の支援先で共通して見た構造をまとめたもので、特定の会社の事例ではありません。
個人情報を入力してよいかの判定表:データ分類×サービス条件
個人情報を含み、学習も閲覧もない契約なら、契約確認のうえで入力できます。逆に、個人情報を含み、学習か閲覧がある条件なら、匿名化してからでなければ入力しません。
判定は、個人情報を含むかと、学習・閲覧の有無の2つの軸で決まります。縦に個人情報の有無、横に学習・閲覧の有無を置いた表にすると、4つのマスに分かれます。
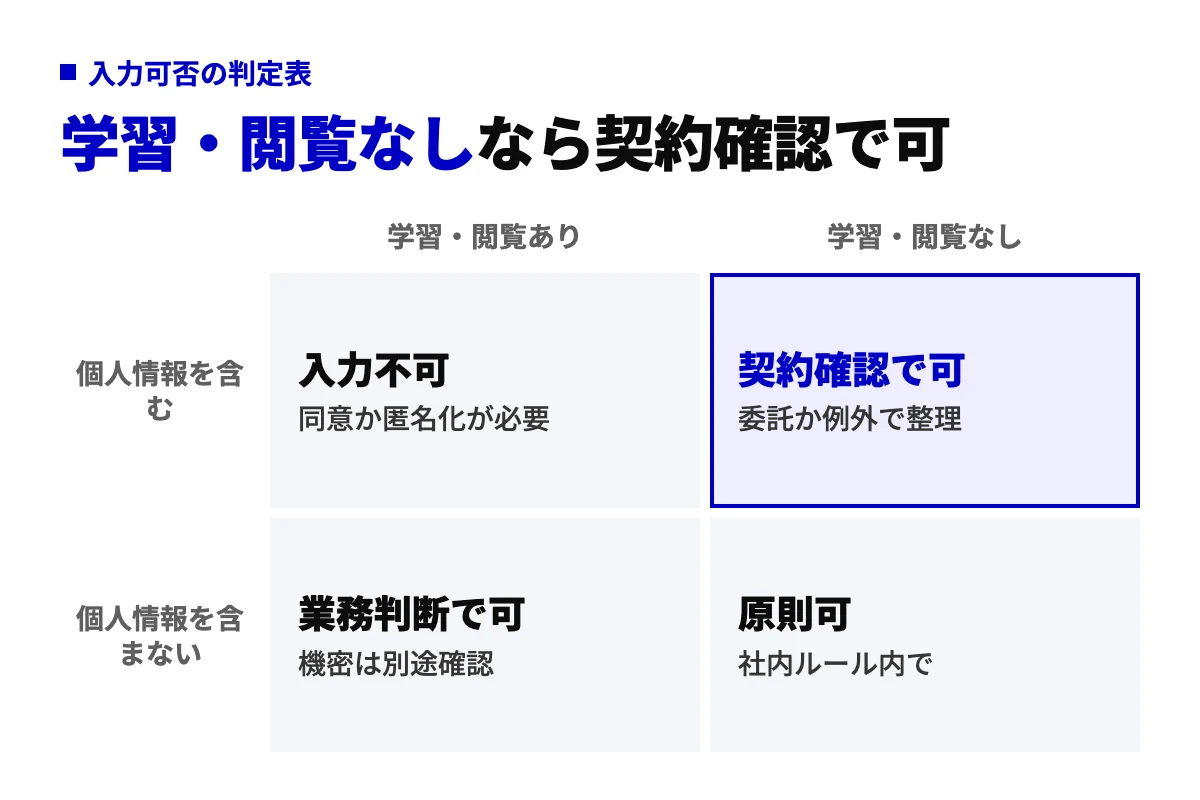
- 個人情報なし×学習・閲覧あり:公開情報や自作の文章なら入力できます。ただし機密情報は別枠で判定します
- 個人情報なし×学習・閲覧なし:業務データも入力できます。契約の範囲内かだけ確認します
- 個人情報あり×学習・閲覧あり:入力しません。匿名化して個人情報を含まない状態にしてから、上のマスへ移します
- 個人情報あり×学習・閲覧なし:契約で委託かクラウド例外に整理できるかを確認のうえ、入力できます
判定の前提:個人情報と機密情報は別枠
個人情報と機密情報は、別の枠で判定します。個人情報は法律上の義務が明確なぶん、契約で整理しやすい側です。取引先から預かった機密情報は、秘密保持契約の条項に左右されるため、別の確認が必要です。
データ格付けの基準:3段階の区分表
判定表を回すには、自社のデータを先に格付けしておく必要があります。私たちは支援先で、公開・社内・個人情報の3段階に分ける格付け表を使っています。
| 区分 | 該当するデータの例 | 学習・閲覧ありのサービス | 学習・閲覧なしのサービス |
|---|---|---|---|
| 公開 | 自社サイトの文章、公開資料、一般的な調べもの | 入力できる | 入力できる |
| 社内 | 議事録の骨子、社内手順、匿名化済みの顧客対応文 | 原則入力しない(機密度で判断) | 契約の範囲内で入力できる |
| 個人情報 | 氏名、連絡先、顧客の問い合わせ本文、録音 | 入力しない | 契約確認のうえ入力できる |
待てば解決する側と待っても解決しない側の違い
株式会社くるみでは、AIの弱点を「待てば解決する側」と「待っても解決しない側」に分けて考えています。学習利用の問題はベンダー側が学習しない方向に動いているため、待てば解決する側です。入力者が自分のデータを分類する作業は待っても解決しない側なので、社内で先に決めます。
AI導入の全体像の記事には、どの業務をAIに任せるかの棚卸し判定表があります。ここでの格付けは、その棚卸しを個人情報の観点から補うものです。
生成AI利用ルールの作り方:入力前の格付けから教育まで
最初にやるのは、データの格付けです。格付けが決まらないと、設定確認も匿名化も契約整理も、何を対象にするかが定まりません。
手順は、格付け、設定確認、匿名化手順、契約整理、教育・監査の5工程です。順番を守ると、後の工程で手戻りが起きにくくなります。
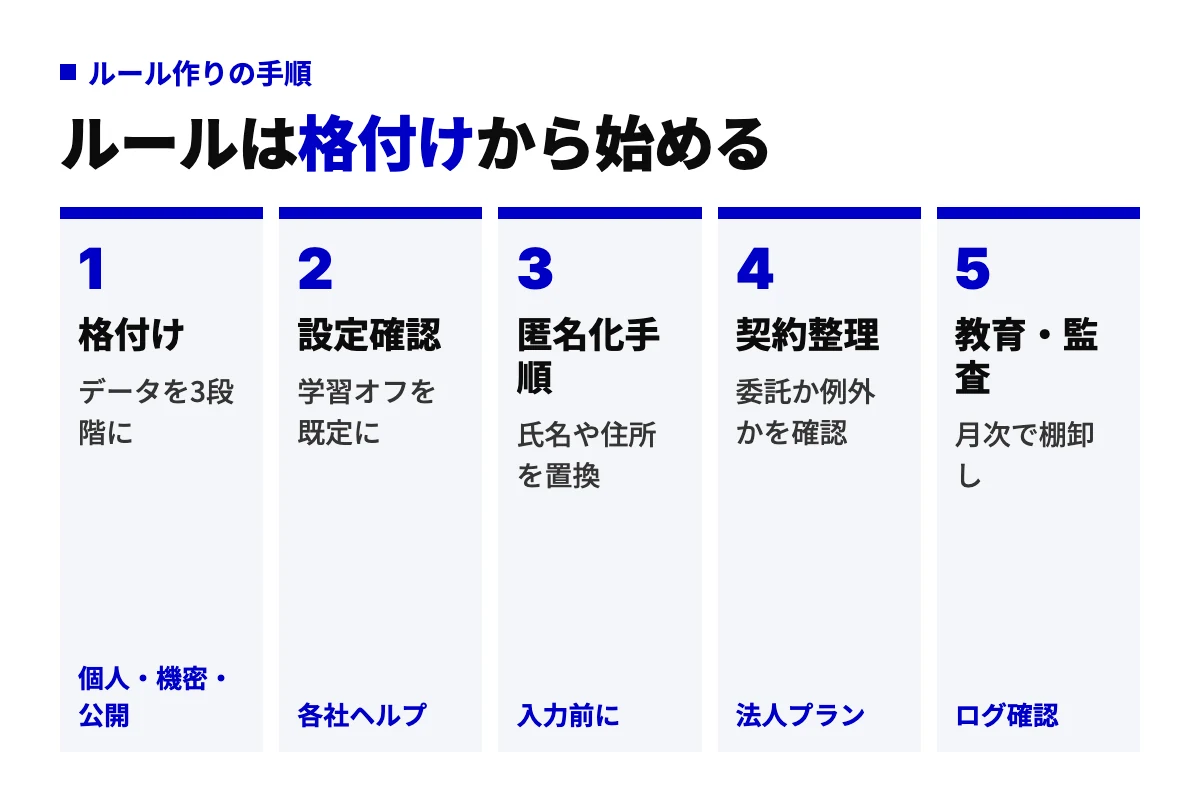
- 格付け:データを3段階に。公開・社内・個人情報に分け、業務ごとにどれを扱うかを一覧にします
- 設定確認:学習オフを既定に。使うサービスの学習設定を確認し、オフを標準にします
- 匿名化手順:氏名や住所を置換。個人情報を含む業務で、入力前に行う置き換えの手順を決めます
- 契約整理:委託か例外かを確認。法人契約の条項を読み、どの区分に整理できるかを確認します
- 教育・監査:月次で棚卸し。ルールを周知し、入力ログと設定を定期的に見直します
匿名化手順の例:置換と丸め
匿名化は、置換と丸めの2つの操作でほとんど対応できます。氏名は「A様」「顧客B」のような記号に置き換え、メールアドレスや電話番号は削除します。住所は市区までに丸め、番地や建物名は落とします。
置換前:山田様(東京都千代田区丸の内〇丁目)からの返品依頼 置換後:A様(東京都千代田区)からの返品依頼
置き換えた対応表は生成AIには渡さず、手元の管理された場所に置きます。出力を受け取ったあと、手元で元に戻す運用にすれば、生成AIの側には個人情報が残りません。
禁止だけではシャドーAIが増える:許可条件の決め方
禁止だけのルールは、社員が個人のアカウントで使う「シャドーAI」を増やします。会社が把握できない経路で業務データが流れる状態は、全面許可より危険です。許可する条件と手順を先に決め、その範囲なら使ってよいと示すほうが、結果として管理が効きます。
運用設計を自社だけで進めにくい場合は、私たちが支援先で回している手順を土台にできます。詳しくは運用設計の支援をご覧ください。中小企業での導入の進め方は、別の記事で扱う予定です。
主要生成AIサービスの学習設定と法人プランの選び方
個人情報を扱うなら、法人プランを選びます。個人向けの無料と有料は公開情報中心の用途に限り、業務データは契約主体が会社になるプランに寄せます。
違いは、学習利用、管理者機能、契約主体、監査ログ、向く用途の観点で見ると整理できます。この観点で個人向け無料、個人向け有料、法人プランを並べると次の図になります。
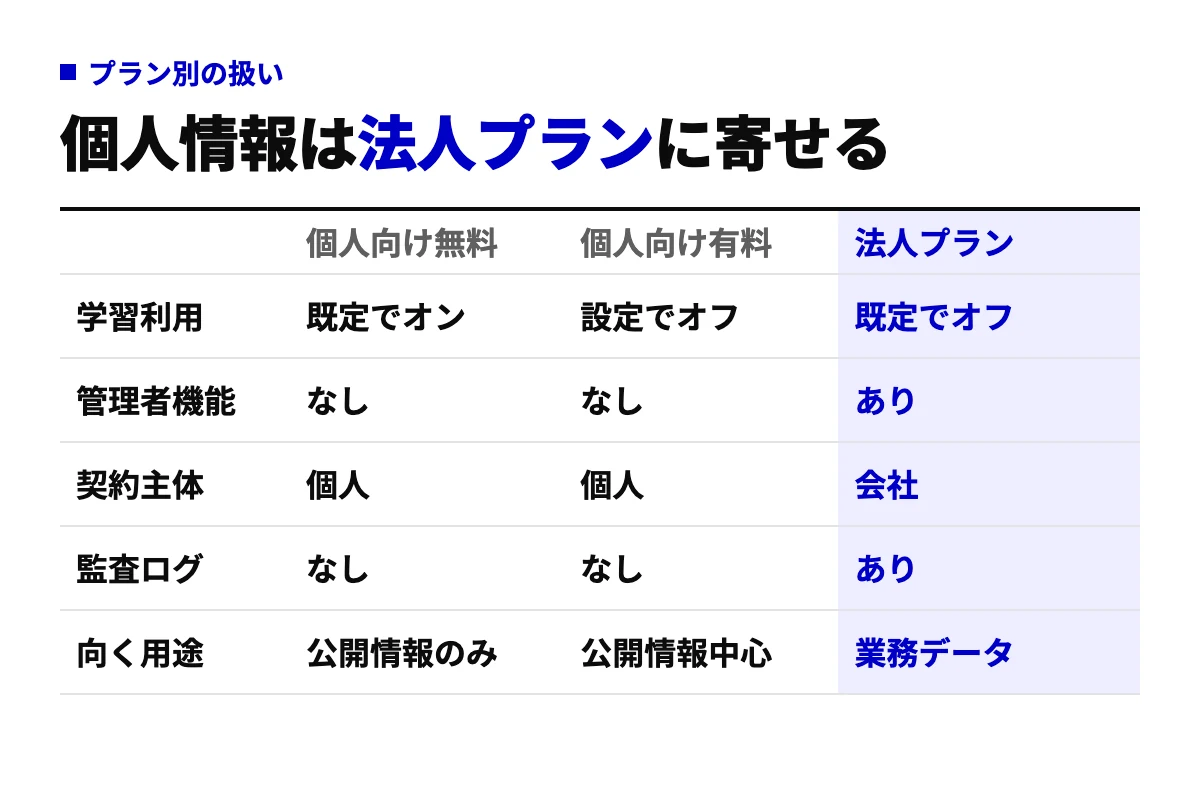
- 学習利用:個人向け無料は既定でオン、個人向け有料は設定でオフ、法人プランは既定でオフが一般的な傾向です
- 管理者機能:個人向けは無料も有料もなし、法人プランはあり。設定を会社側で統制できるかの差です
- 契約主体:個人向けは個人、法人プランは会社。委託やクラウド例外に整理できるかは、ここで決まります
- 監査ログ:個人向けはなし、法人プランはあり。誰が何を入力したかを後から確認できます
- 向く用途:個人向け無料は公開情報のみ、個人向け有料は公開情報中心、法人プランは業務データです
ここに挙げた内容は、主要サービスの一般的な傾向です(2026年9月時点)。仕様は変わるため、各社の公式ヘルプで最新の状態を確認してください。
入場券とPODの違い:学習オフは前提条件
株式会社くるみでは、機能を「入場券」と「POD(差が付く点)」に分けて評価しています。学習オフは入場券で、どのプランでも設定できる時点で差は付きません。差が付くのは、管理者機能、監査ログ、契約主体の3つです。
法人プランの選び方:契約主体と監査ログを確認
法人プランを選ぶときに確認するのは、契約主体が会社になるか、学習が既定でオフか、監査ログを管理者が見られるかの3点です。この3点がそろえば、個人情報を含む業務を委託かクラウド例外に整理する前提が整います。料金より先に、この3点を確認します。
ChatGPTの法人向けプランの違いは、詳しくはChatGPTの法人プラン比較にまとめています。Geminiの法人利用については、別の記事で扱う予定です。
私たちはこう回している:全面禁止ではなく「分類して許可」する運用
私たちは、全面禁止ではなく「分類して許可」する運用に切り替えています。個人情報を含む業務も、判定表で格付けし、法人プランか匿名化を経てから使うと決めました。
運用の変化を並べると、全面禁止から分類して許可への切り替えです。両側で何が変わるかを次の図に示します。
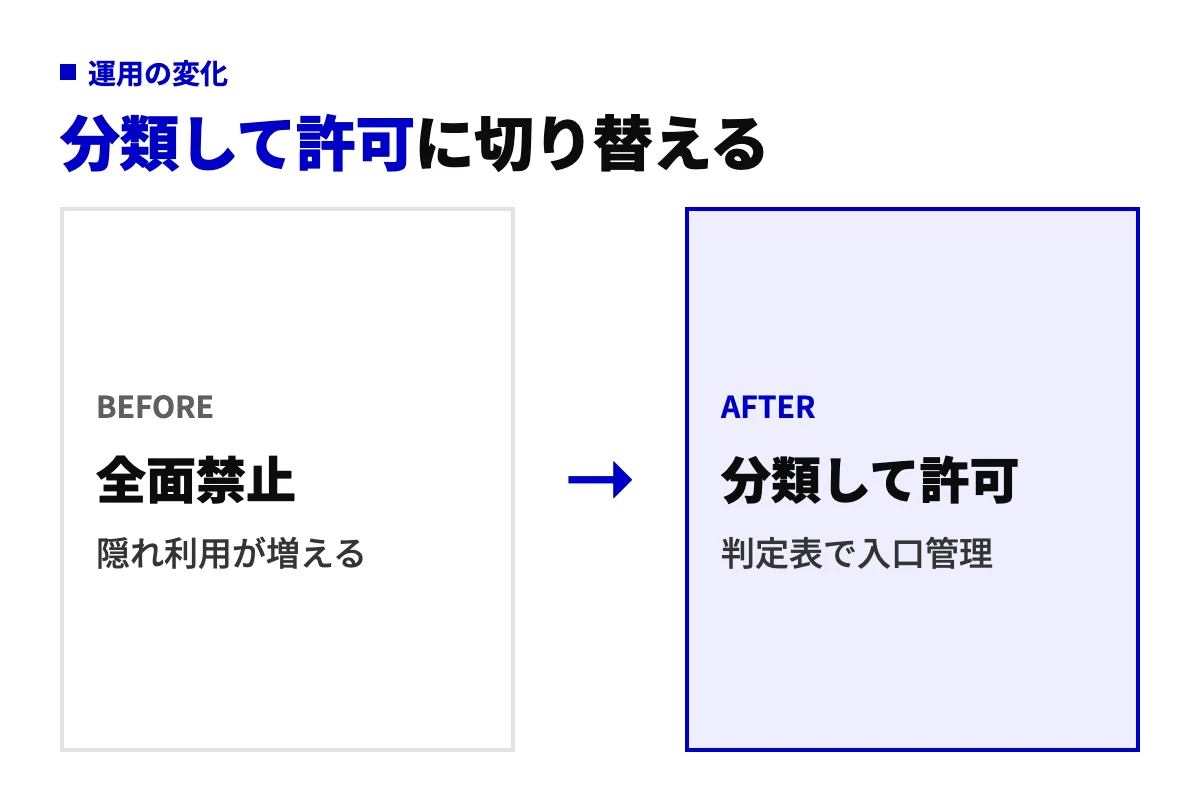
- 全面禁止:個人情報を含む業務ではAIを使わない。守りやすい一方で、個人アカウントでの利用が増え、会社が把握できなくなります
- 分類して許可:判定表で格付けし、条件を満たす経路でだけ使う。手順は増えますが、会社が把握できる範囲で使えます
私たちの運用手順:判定・経路・棚卸しの3点
私たちの回し方は3点です。入力前に判定表で格付けする、個人情報を含む業務は法人プランか匿名化を経てから使う、月次で入力ログと設定を棚卸しする、の3つに絞っています。
- 入力前に判定表で格付けする:業務ごとに扱うデータを公開・社内・個人情報に分け、どのマスに入るかを先に決めます
- 個人情報を含む業務は法人プランか匿名化を経てから:契約主体が会社のプランで使うか、置換と丸めを済ませてから使います
- 月次で入力ログと設定を棚卸しする:管理者機能で入力ログを見て、学習設定と連携先が変わっていないかを確認します
運用の注意点:判定表と手順を切り離さない
判定表だけでは、社員がどう匿名化するかまでは決まりません。手順だけでは、どのデータが対象かが決まりません。前の節の判定表と手順を組み合わせて使います。
私たちが決めたのは、判定表と手順を切り離さないことです。判定表で「個人情報あり×学習・閲覧あり」に入ったデータは、匿名化手順を経て「個人情報なし」のマスへ移す、という動線を最初から決めています。
業務での使い方の具体例は、詳しくは生成AIの業務活用例にまとめています。私たちはこの流れで回しています。
生成AIと個人情報に関するよくある質問
生成AIに個人情報を入力すると第三者提供になりますか
事業者が入力内容を学習など自社目的に使う設定なら、第三者提供に当たり得ます。学習も閲覧もしない契約なら、委託かクラウド例外に整理され、提供に当たらないとする考え方が一般的です(2026年9月時点)。契約内容で結論が変わるため、最終判断は専門家に確認してください。
学習オフに設定すれば個人情報を入力してよいですか
学習オフは前提条件の一つで、それだけでは足りません。保存期間と閲覧の条件、契約主体が会社かどうか、利用目的の範囲内かを合わせて確認します(2026年9月時点)。個人アカウントの学習オフは契約主体が個人のままなので、業務データは法人プランに寄せます。最終判断は専門家に確認してください。
個人情報保護委員会の注意喚起は何を求めていますか
2023年6月の注意喚起は、事業者に対して、利用目的の達成に必要な範囲内で入力すること、応答以外の目的で学習に使われないかを確認することを求めています。個人には、不用意に個人情報を入力しないことと利用規約の確認を促しています(2026年9月時点)。入力の禁止ではなく、確認の要請です。適用の判断は専門家に確認してください。
社員が個人の無料アカウントで業務に使っていたらどうしますか
責めるより先に、会社が許可する経路を用意します。無料アカウントは学習が既定でオンの場合が多く、契約主体も個人です(2026年9月時点)。すでに入力した内容は履歴を削除し、法人プランか匿名化手順へ移行してもらいます。個人情報が含まれていた場合の届出や本人対応は、専門家に確認してください。
匿名化すれば個人情報に当たらなくなりますか
氏名や連絡先を置き換え、他の情報と照合しても個人を特定できない状態にすれば、個人情報に当たらない整理が可能です。ただし、手元に対応表を残す場合は、仮名加工情報として別の義務がかかる可能性があります(2026年9月時点)。どの程度の加工で足りるかは、専門家に確認してください。
まとめ:個人情報は「分類して許可」し、判定表で入口を管理する
個人情報は、分類して許可し、判定表で入口を管理します。入力可否は、個人情報の有無、学習の有無、保存先と契約、利用目的の4つで決まります。全面禁止にする必要はなく、条件を満たす経路を用意するほうが管理は効きます。
- 個人情報の有無:含まなければ判定は軽くなり、含めば匿名化か法人契約が前提になります
- 学習の有無:学習オフは入場券で、まず確認する項目です
- 保存先と契約:契約主体が会社か、委託かクラウド例外に整理できるかを見ます
- 利用目的:本人に示した目的の範囲内かを、区分とは別に確認します
次の一手:明日から始める3つの手順
- 自社データの格付け表を作る。公開・社内・個人情報の3段階で、業務ごとに一覧にします
- 学習・閲覧の条件を契約で確認する。設定画面だけでなく、規約と法人契約の条項を読みます
- 個人情報を扱う業務は法人プランへ寄せる。契約主体が会社になる経路を用意します
棚卸しの進め方と相談先
どの業務をAIに任せてよいかの棚卸しは、個人情報の判定と一緒に進めると手戻りが減ります。私たちは、業務の棚卸しの入口としてAIおきかえくんの無料診断を使っています。AI導入全体の進め方は、冒頭で触れたAI導入の全体像の記事で整理しています。
生成AIの社内ルール作りや、個人情報を含む業務の運用設計で迷う点があれば、株式会社くるみにご相談ください。現状の使い方をお聞きして、判定表と手順の形に整えるところから一緒に進めます。